Хранилище данных
В предыдущей статье мы уже начали говорить о хранилищах данных.
Хранилища данных нужны, чтобы анализировать данные. Чтобы анализировать данные —
их нужно где-то хранить.
Можно справедливо заметить, что данные уже хранятся в системе-источнике. Например, в CRM или бухгалтерской системе. Почему их нельзя анализировать прямо в источнике?
Давайте разбираться.
Хранилища данных нужны, чтобы анализировать данные. Чтобы анализировать данные —
их нужно где-то хранить.
Можно справедливо заметить, что данные уже хранятся в системе-источнике. Например, в CRM или бухгалтерской системе. Почему их нельзя анализировать прямо в источнике?
Давайте разбираться.
Что такое хранилище данных?
Операционные
системы
системы
Это приложения, с которыми работает много пользователей. Например, с CRM системой могут работать тысячи продавцов или специалистов технической поддержки. Обычно дата-специалисты называют их системами-источниками.
Системы с которыми работает меньше сотрудников, чем с операционными системами. Обычно дата-специалисты называют их хранилищами данных. С хранилищами работают аналитики, стратеги — люди которые должны анализировать отдельные процессы и решать «большие» проблемы. Например, у аналитика может быть задача — предложить решения как повысить эффективность работы технической поддержки.
Аналитические
системы
системы
Сводные
(приведены к корпоративному формату)
(приведены к корпоративному формату)
Детальные
Представляют версию записи (или снимок) в момент времени
Актуальные в момент доступа
Модель данных ориентирована
на предметную область (для анализа)
на предметную область (для анализа)
Модель данных ориентирована на приложение (для оперативного учета)
Сниженные требования ко времени отклика
Высокие требования ко времени отклика
Доступ к чтению и обработке
отдельного набора записей
отдельного набора записей
Доступ к чтению и обработке
отдельной записи
отдельной записи
Управление обновлением записи не используется
Управление обновлением записи серьезная проблема процесса обработки данных
Представьте ситуацию. Вы звоните в колл-центр, чтобы решить техническую проблему «здесь
и сейчас". Но вам приходится ждать на линии несколько минут, потому что все операторы заняты. Это очень раздражает, правда?
Примерно такая же ситуация возникнет, если начать анализировать информацию в операционной системе. Менеджер пытается открыть карточку клиента, а в ответ получает «подождите, система занята — выполняется запрос аналитика на 100 500 строк». Такое положение дел не понравится, ни менеджеру, ни клиенту, ни самому аналитику.
Почему нельзя анализировать данные
в источнике?
в источнике?
Аналитические данные
Оперативные данные
В аналитической системе важно:
- Получать много информации — статистика начинается с тысяч и миллионов записей.
- Информация может быть «вчерашней свежести» — аналитику необязательно знать, какие проблемы у клиентов именно сегодня и сейчас. Важно знать, какие проблемы встречаются чаще всего.
- Аналитик запрашивает из системы тысячи записей и может подождать результатов запроса несколько минут — у него нет в это время клиентов на линии.
Чтобы повысить эффективность работы технической поддержки, компании нужно смотреть не на каждую отдельную заявку, а на статистику по заявкам пользователей. Например, заявки какого типа дольше находятся в работе? В какое время клиенты дольше ожидают на линии? С какими вопросами чаще обращаются клиенты? Статистика покажет — где самые большие проблемы в технической поддержке, а работа над самым слабым элементом процесса даст самый высокий эффект.
То есть в любой операционной системе важно:
- Быстро получить нужную информацию
- Получать актуальную информацию
- Получать информацию порционно (1 клиент, 1 обращение в тех.поддержку = 1 запись в БД)
Каждый из пользователей обычно работает в один момент времени с 1-2 записями: открывают карточки клиента, или карточки обращений в техническую поддержку. Для пользователей важно, чтобы карточки открывались очень быстро. Если карточка обращения клиента будет открываться даже 10 секунд — это уже долго. Чем быстрее менеджер обслуживает одного клиента, тем меньше время ожидания на линии колл-центра и больше довольных клиентов.
Чем отличаются операционные системы от аналитических?
Как в общих чертах устроено хранилище?
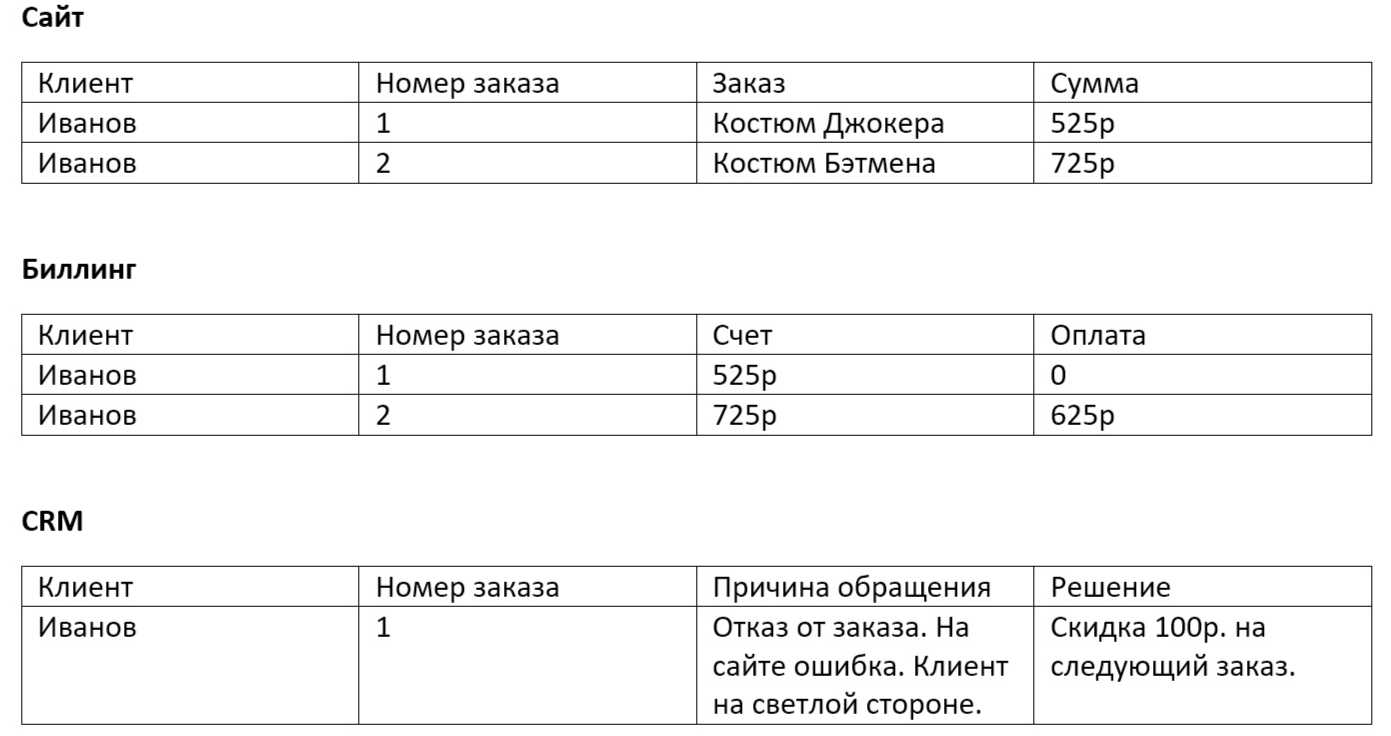
Исходная информация из систем источников может выглядеть вот так:
Данные из источников загружаются в БД хранилища, там агрегируются и оттуда передаются пользователям.
Допустим, у нас есть 3 системы-источника:
Допустим, у нас есть 3 системы-источника:
- Сайт, где клиенты могут сделать заказ
- Биллинг, в котором хранятся данные о счетах и платежах клиентов
- CRM система, в которой менеджеры регистрируют обращения и проблемы клиентов
В хранилище загружаются исходные данные из систем-источников, а потом они трансформируются в нужные агрегированные представления. Агрегаты могут создаваться по разным причинам и для разных задач.
Еще несколько примеров про работу агрегаторов:
Еще несколько примеров про работу агрегаторов:
- Компания может вести бизнес в разных регионах и в каждом регионе стоит отдельная информационная система. В хранилище региональные данные могут агрегироваться в данные о всей компании.
- Данные о разных клиентах могут храниться в разных системах. Например, для юридических лиц — своя CRM, а для физических лиц — другая. В хранилище данные могут агрегироваться в единую сущность — клиенты
- Разные информационные системы могут фиксировать разные аспекты одной сущности. Как и в нашем примере — одна система фиксирует заказы, вторая платежи, а третья — проблемы. Агрегат может содержать всю информацию о клиенте.
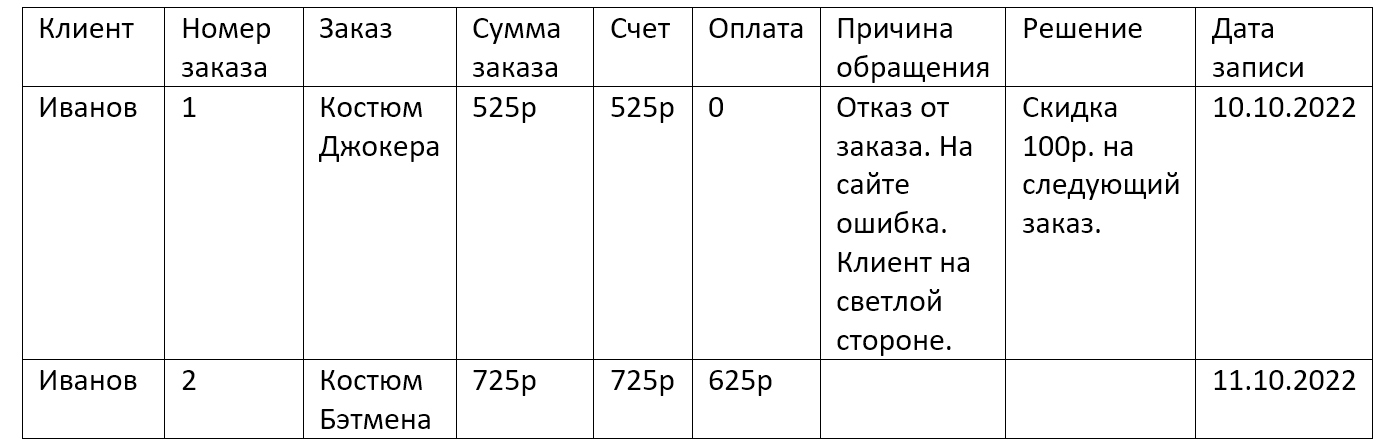
А агрегированная информация по клиенту «Иванов» в хранилище может выглядеть вот так:
Зависимость от времени
Данные в хранилище не меняются, но реальные объекты изменяются. Например, стоимость заказов может изменяться и в жизни, и в системе-источнике. В хранилище загружаются все срезы данных, но они должны быть привязаны к промежутку и моменту времени.
Данные в хранилище не меняются. Если запись однажды попала в хранилище — она должна там остаться. Корректировать или удалять данные из хранилища нельзя.
Некорретируемость
Данные в хранилище должны решать проблемы всей компании, а не одного бизнес-подразделения. Каждая система-источник решает отдельную задачу, а в хранилище стремятся создать агрегированные представления данных, которые полезны всем.
Интегрированность
Проблемно-предметная ориентация
Данные в хранилищах организуют по объектам управления. То есть по предметным областям, с которыми работает компания.
Например, это могут быть:
Например, это могут быть:
- Клиенты
- Заказы
- Технические проблемы
Из всего сказанного можно сделать важные выводы о характеристиках хранилищ данных.
Важные выводы
СУБД и хранилище данных это одно и тоже?
СУБД — это технология управления базами данными.
БД используется и для построения операционных систем, например, сайтов, и для построения аналитических систем — хранилищ данных.
Можно сказать, что БД — это что-то маленькое. А хранилище данных — что-то огромное, содержащее в себе информацию из множества источников.
БД используется и для построения операционных систем, например, сайтов, и для построения аналитических систем — хранилищ данных.
Можно сказать, что БД — это что-то маленькое. А хранилище данных — что-то огромное, содержащее в себе информацию из множества источников.
Хранилище данных и платформа данных это одно и тоже?
Хранилище данных решает задачу сохранения исходных и агрегированных данных из разных источников.
А платформа данных — автоматизирует все процессы управления данными (см. предыдущий лонгрид — экосистема).
Платформа данных включает в себя различные инструменты для загрузки\выгрузки данных, технологии озер данных, технологии контроля качества данных. Мы об этом еще поговорим на нашем марафоне.
А платформа данных — автоматизирует все процессы управления данными (см. предыдущий лонгрид — экосистема).
Платформа данных включает в себя различные инструменты для загрузки\выгрузки данных, технологии озер данных, технологии контроля качества данных. Мы об этом еще поговорим на нашем марафоне.
Как работать с хранилищем данных?
Извлекать информацию из хранилища можно с помощью специального приложения (SQL-клиента). В таком приложении можно формировать SQL-запросы к хранилищу или базе данных, и получать запрошенную информацию. SQL — язык структурированных запросов, который используется для работы с базами данных.
Как появились хранилища?
Родителями хранилищ данных считают Билла Инмона и Ральфа Кимбалла. Хотя эти двое и были в основном сосредоточены на аспектах хранения данных, связанными с базами данных.
А датой рождения КХД принято считать 1990-е года. Мы еще вспомним две эти фамилии, когда будем говорить про архитектуры хранилищ данных в следующем лонгриде.
А датой рождения КХД принято считать 1990-е года. Мы еще вспомним две эти фамилии, когда будем говорить про архитектуры хранилищ данных в следующем лонгриде.
Для чего используются хранилища данных?
Хранилища данных используются для различных целей, включая бизнес-аналитику и научные исследования. Анализируя большие объемы данных за длительный период времени, пользователи могут выявлять тенденции и закономерности, которые могут быть невидимы в небольших наборах данных.
Это помогает принимать лучшие решения и повышать эффективность бизнеса.
Это помогает принимать лучшие решения и повышать эффективность бизнеса.
Рубрика: 5 вопросов от джуна
Open-source в Enterprise: это фантастика?
- Open source и enterprise – понятия взаимоисключающие или дополняющие?
- Риски при использовании open source проектов. Реальные кейсы российского рынка.
- Как не утонуть в проблемах эксплуатации open-source проектов, которых появляется всё больше?
Как построить хранилище данных, так чтобы оно работало.
- Изменения в работе с данными за последние 10 лет. Новые вызовы и метрики, которыми эти вызовы измеряются (4V’s of Big Data) — то, о чём ещё не говорят в университете.
- Ключевые тренды, связанные с DWH. Набирающие вес технологии и языки.
Направления и тенденции развития баз данных
- MPP системы
- Основы Greenplum
Эволюция аналитических хранилищ данных
- Тенденции
- Хронология
- Способы интеграции данных в хранилище
Рекомендуем следующие видео по теме:
Подборка ссылок для самых любознательных
